Comment entraîner une IA sans partager ses données ?
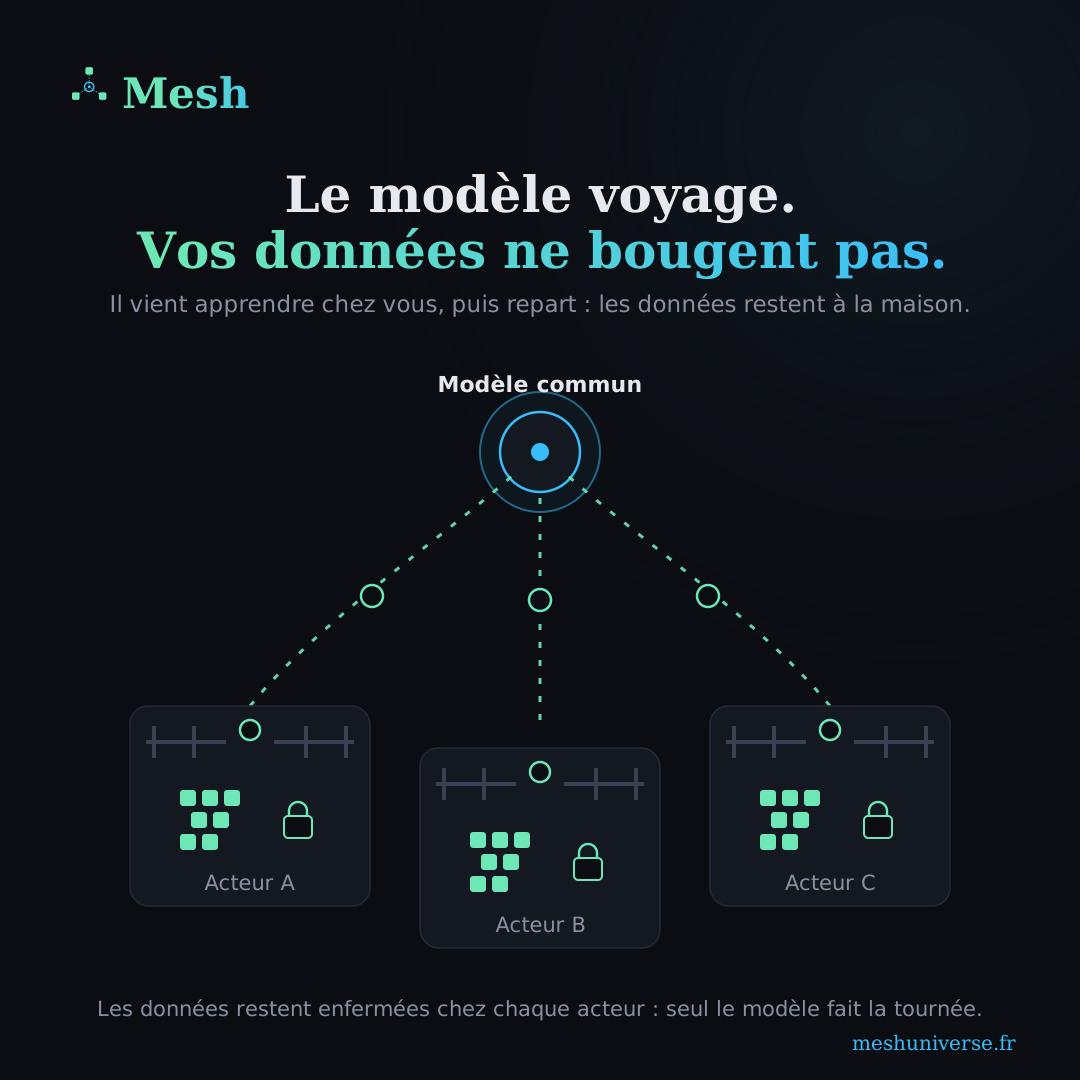
On entraîne une IA sans partager ses données grâce à l'apprentissage fédéré : au lieu d'envoyer vos données vers un serveur central, c'est le modèle qui vient s'entraîner chez vous. Vous l'entraînez localement, sur vos propres données, puis vous ne renvoyez que le résultat de cet entraînement : les paramètres du modèle, jamais les données. Un coordinateur combine les contributions de tous les participants pour produire un modèle commun, meilleur que celui de chacun. À aucun moment vos données ne sont copiées, transférées ou rendues lisibles par un tiers. C'est le principe de Mesh : le modèle voyage, les données restent à la maison.
En pratique : les 4 étapes
Pour entraîner une IA sans partager ses données, le déroulé est toujours le même :
- Vous recevez le modèle, pas l'inverse. Un coordinateur envoie une copie du modèle en cours à chaque participant, dans une enveloppe chiffrée de bout en bout que vous seul pouvez ouvrir.
- Vous entraînez chez vous. Le modèle s'entraîne sur vos données locales, à l'intérieur de votre infrastructure. Rien ne sort. Vos lignes de données ne sont même jamais mises en forme pour être envoyées.
- Vous ne renvoyez que des réglages. À la fin, vous transmettez uniquement la mise à jour du modèle, une liste de nombres (les poids), chiffrée. Ces nombres décrivent ce que le modèle a appris, pas ce qu'il a vu.
- Le coordinateur agrège. Il combine les mises à jour de tous les participants (algorithme FedAvg) pour produire un nouveau modèle commun, qu'il vous renverra au tour suivant. On répète jusqu'à obtenir un bon modèle.
Résultat : un modèle entraîné par le collectif, sans qu'aucune donnée ne sorte de chez qui que ce soit.
Pourquoi ça marche : ce qui circule n'est pas vos données
La question qui vient toujours : « si le modèle apprend de mes données, est-ce qu'il ne les emporte pas avec lui ? »
Non. Ce qui circule, ce sont des paramètres de modèle, des coefficients numériques. Chez Mesh, une mise à jour typique fait quelques centaines d'octets : c'est le réglage d'un modèle, pas un extrait de vos données. Aucune de vos lignes n'est jamais sérialisée ni transmise (c'est vérifiable dans le code : seuls les poids, le nombre d'exemples et les métadonnées de round sont sérialisés, jamais les données d'entraînement).
Deux protections s'ajoutent selon le niveau d'exigence :
- Chiffrement de bout en bout (par défaut) : même l'infrastructure qui transporte les paramètres ne peut pas les lire.
- Confidentialité différentielle (en option) : un bruit calibré est ajouté aux paramètres pour empêcher de remonter à un individu à partir des réglages partagés.
Est-ce que je dois faire confiance aux autres participants ?
Vous n'échangez rien directement avec les autres participants. Chaque contribution est chiffrée pour le coordinateur uniquement ; les acteurs ne voient jamais les données ni les modèles les uns des autres. Chacun garde ses données chez lui, en clair, et ne les montre à personne, pas même au coordinateur.
Qu'est-ce que ça change concrètement ?
Entraîner une IA sans partager ses données débloque des situations qui étaient impossibles autrement :
- Des concurrents peuvent améliorer ensemble un même modèle sans se livrer leurs données. Chacun repart plus fort, personne n'a rien exposé.
- Des données réglementées (santé, banque, données personnelles) peuvent servir à entraîner un modèle sans transfert, ce qui facilite la conformité RGPD (minimisation native).
- Un acteur avec un angle mort (il ne mesure qu'une partie de la réalité) obtient un modèle qui « sait » des choses qu'il n'a jamais observées, parce que d'autres les ont observées à sa place. Sans jamais accéder à leurs données.
Comment démarrer avec Mesh
Mesh est une plateforme d'apprentissage fédéré confidentiel. Selon votre situation :
- Vous voulez rejoindre ou monter un consortium pour entraîner un modèle commun → Le Collectif.
- Vous détenez beaucoup de données et voulez être payé pour leur contribution sans les exposer → Rente de Données.
- Vous voulez comprendre la technologie sous-jacente → Apprentissage fédéré et IA confidentielle.
FAQ : Entraîner une IA sans partager ses données
Peut-on vraiment entraîner une IA sans partager ses données ?
Oui. L'apprentissage fédéré rend cela possible : chaque acteur entraîne le modèle sur ses propres données, en local, et ne partage que les paramètres appris, jamais les données brutes.
Qu'est-ce qui est envoyé, si ce ne sont pas les données ?
Uniquement les paramètres du modèle (les « poids ») : une liste de nombres qui décrit ce que le modèle a appris. Chez Mesh, ces paramètres sont chiffrés de bout en bout ; aucune ligne de données n'est jamais transmise.
Est-ce plus sûr que d'anonymiser mes données avant de les partager ?
C'est une approche différente et souvent plus robuste : plutôt que d'anonymiser puis transférer (l'anonymisation pouvant être réversible), on ne transfère pas les données du tout. Elles ne quittent jamais votre infrastructure.
Puis-je entraîner une IA avec des concurrents sans qu'ils voient mes données ?
Oui : c'est l'un des principaux cas d'usage. Les participants ne s'échangent rien directement ; chacun garde ses données et ne partage que des paramètres chiffrés.
Le modèle final m'appartient-il ?
Vous pouvez récupérer le moteur entraîné, le faire tourner chez vous et l'affiner en privé sur vos propres données. La gouvernance précise du modèle collectif (droits de chaque contributeur) se définit dans le cadre du consortium.
Voyons ce que ça donne sur vos données
Une démonstration interactive est disponible sur demande, nous vous en donnons l'accès.