Apprentissage fédéré : définition, fonctionnement et cas d'usage
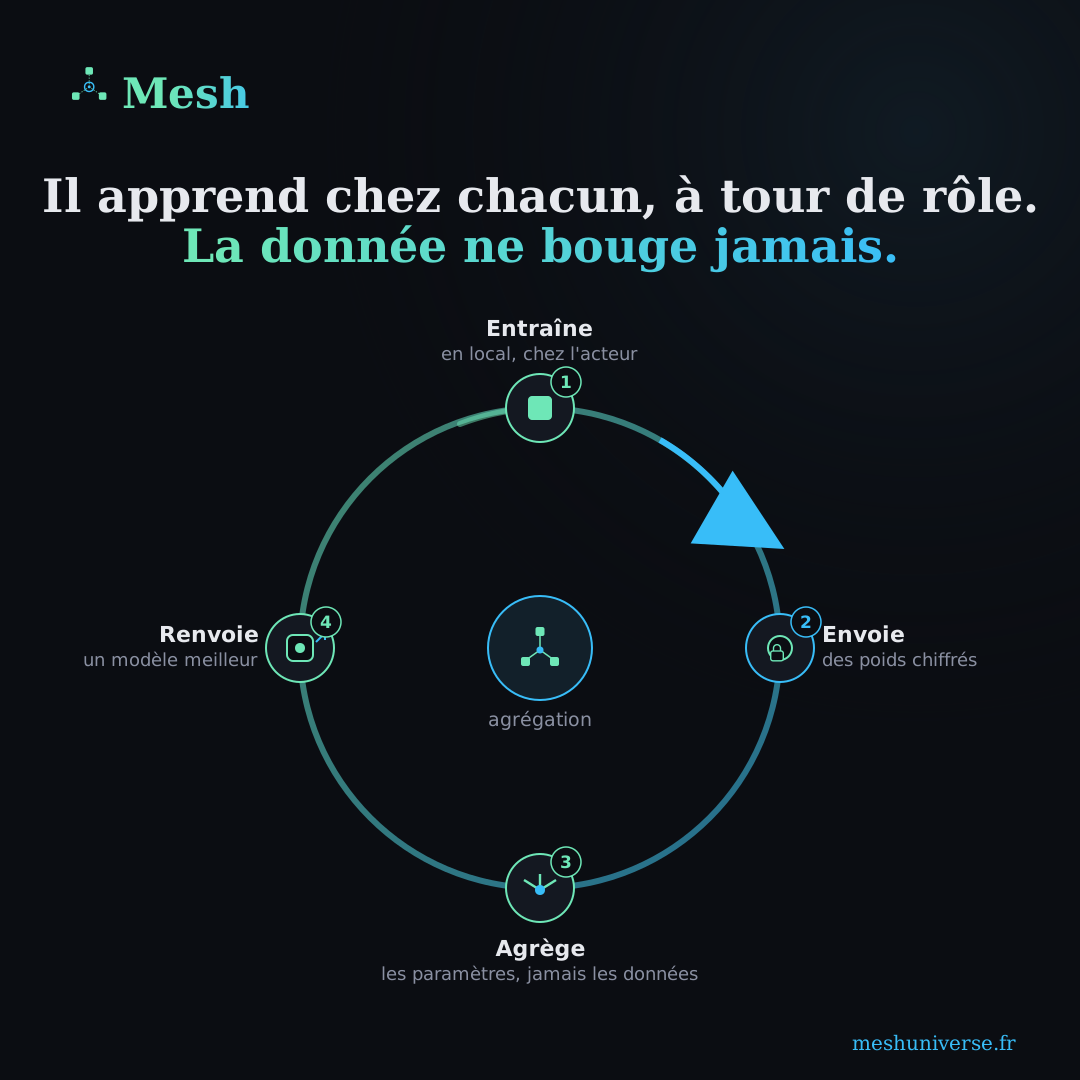
L'apprentissage fédéré (federated learning) est une méthode d'entraînement de l'intelligence artificielle dans laquelle plusieurs acteurs entraînent un même modèle sans jamais centraliser ni partager leurs données. Chacun entraîne le modèle localement, sur ses propres données ; seules les mises à jour du modèle (ses paramètres) circulent, jamais les données brutes. Le résultat est une IA entraînée par le collectif, meilleure que celle que chaque acteur obtiendrait seul, sans qu'aucune donnée ne sorte de son infrastructure d'origine. Et en option, la combinaison des paramètres du modèle peut se faire dans une enclave : l'enclave ne voit jamais les données, elle est l'endroit où les modèles sont fédérés, et personne n'y a accès au modèle d'un seul membre (l'enclave se détruit quand le modèle final est livré).
Chez Mesh, ce principe se résume en une phrase : le modèle voyage, les données restent à la maison.
Qu'est-ce que l'apprentissage fédéré ?
L'apprentissage fédéré est une technique d'apprentissage automatique (machine learning) où l'entraînement d'un modèle est distribué entre plusieurs participants qui gardent le contrôle de leurs données.
Dans l'approche classique (dite centralisée), on rassemble toutes les données dans un même entrepôt, puis on entraîne le modèle dessus. L'apprentissage fédéré inverse ce schéma : c'est le modèle qui se déplace vers les données, pas les données qui se déplacent vers le modèle. Chaque participant entraîne une copie du modèle sur ses données locales, puis renvoie uniquement le résultat de cet entraînement (les paramètres du modèle, les « poids ») à un coordinateur qui les combine.
Ce que coûte cette inversion est mesuré : sur les trois jeux de données publics de notre banc, le modèle fédéré est à 0,3 point d'AUC au plus du modèle qu'on obtiendrait en rassemblant tout au même endroit, pour une incertitude de mesure au moins six fois plus grande. Déplacer le modèle au lieu des données ne fait donc rien perdre de mesurable. → la démonstration et ses chiffres.
Le terme a été introduit par des chercheurs de Google en 2016-2017, avec l'algorithme FedAvg (Federated Averaging), initialement pour entraîner des modèles sur les téléphones des utilisateurs sans remonter leurs données personnelles vers un serveur central. Référence : H. B. McMahan, E. Moore, D. Ramage, S. Hampson, B. Agüera y Arcas, « Communication-Efficient Learning of Deep Networks from Decentralized Data », AISTATS 2017, PMLR 54, p. 1273-1282, proceedings.mlr.press/v54/mcmahan17a.html.
Apprentissage fédéré ≠ mise en commun des données
Point essentiel, souvent mal compris : l'apprentissage fédéré ne consiste pas à regrouper les données de plusieurs acteurs dans un espace partagé. Les données ne sont ni copiées, ni transférées, ni fusionnées. Chaque acteur conserve les siennes, chez lui, en clair. Ce qui est mis en commun, c'est l'apprentissage, pas la matière première.
C'est la distinction que Mesh formule ainsi : une IA entraînée par le collectif, pas sur des données mutualisées.
Comment fonctionne l'apprentissage fédéré ?
L'entraînement se déroule en cycles appelés rounds (tours). Voici le déroulé d'un round, tel qu'il est réellement implémenté dans le moteur de démonstration Mesh :
- Diffusion. Le coordinateur envoie le modèle global courant à chaque participant. Chez Mesh, cet envoi est chiffré de bout en bout (RSA-OAEP 2048 bits + AES-GCM 256 bits) : une enveloppe par participant.
- Entraînement local. Chaque participant entraîne ce modèle sur ses propres données, sans les faire sortir. À la fin, il calcule la différence entre le modèle reçu et le modèle obtenu : c'est sa « mise à jour ».
- Remontée. Chaque participant renvoie uniquement sa mise à jour de modèle (des nombres : les poids), chiffrée, au coordinateur. Aucune ligne de données d'entraînement n'est jamais sérialisée ni transmise.
- Agrégation. Le coordinateur combine les mises à jour reçues (voir FedAvg ci-dessous) pour produire un nouveau modèle global, amélioré.
- Répétition. On recommence, round après round. Le modèle global accumule progressivement une connaissance qu'aucun participant ne possédait seul.
Le schéma, en mots
Imaginez trois usines, A, B et C, chacune dans son bâtiment, chacune avec ses machines et ses capteurs. Au centre, un coordinateur. À chaque round :
- le coordinateur poste à A, B et C une même copie du modèle en cours (dans une enveloppe scellée que seul le destinataire peut ouvrir) ;
- A, B et C ouvrent l'enveloppe, entraînent le modèle sur leurs propres relevés sans que rien ne sorte de leurs murs, puis renvoient au coordinateur une enveloppe scellée contenant seulement des réglages de modèle, pas leurs relevés ;
- le coordinateur ouvre les trois enveloppes, fait la moyenne des réglages, et obtient un modèle un peu meilleur, qu'il repostera au round suivant.
Au bout de plusieurs rounds, le modèle central « sait » des choses issues des trois usines, alors que rien de ce que mesure l'usine A n'a jamais été vu par B ou C, ni par le coordinateur.
Qu'est-ce que FedAvg ?
FedAvg (Federated Averaging) est l'algorithme d'agrégation de référence de l'apprentissage fédéré. Son principe : le nouveau modèle global est la moyenne des modèles locaux, pondérée par la quantité de données de chaque participant. Un acteur qui a entraîné sur 10 000 exemples pèse davantage qu'un acteur qui en a 500. Formellement, si p_i est la part de données du participant i et w_i son modèle après entraînement local, le modèle agrégé vaut la somme des p_i × w_i.
C'est un mécanisme simple et robuste, adapté aux modèles convexes. Sur des modèles plus complexes (réseaux de neurones profonds), des variantes existent (FedProx, SCAFFOLD, FedAdam) pour gérer l'hétérogénéité entre participants.
Quels sont les cas d'usage de l'apprentissage fédéré ?
L'apprentissage fédéré est pertinent partout où les données sont à la fois précieuses et impossibles à partager, pour des raisons réglementaires, concurrentielles ou contractuelles. Quelques exemples :
- Industrie : maintenance prédictive inter-usines. Plusieurs sites (voire plusieurs entreprises) entraînent un modèle commun de détection de pannes sans échanger leurs données de production, souvent stratégiques.
- Banque : détection de fraude inter-établissements. Des banques concurrentes améliorent ensemble un modèle anti-fraude sans partager les transactions de leurs clients.
- Santé : recherche sur données patients. Des hôpitaux entraînent un modèle sur des cohortes réparties, sans que les dossiers médicaux quittent chaque établissement.
- Cybersécurité : détection d'intrusion collaborative. Des organisations mutualisent la détection de menaces sans exposer leurs journaux (logs), eux-mêmes sensibles.
- Téléphonie / edge. Le cas d'origine : entraîner sur les appareils des utilisateurs (clavier prédictif, reconnaissance vocale) sans remonter les données personnelles.
Le fil commun : chaque acteur pris isolément a un angle mort : il ne mesure ou n'observe qu'une partie de la réalité. La fédération donne à chacun accès à ce qu'il ne voit pas, sans lui demander d'exposer ce qu'il voit.
Apprentissage fédéré ou confidential computing : quelle différence ?
Ce sont deux technologies de protection des données (privacy-enhancing technologies, PET), mais elles ne fonctionnent pas de la même façon.
| Apprentissage fédéré | Confidential computing | |
|---|---|---|
| Où sont les données ? | Chez chaque acteur, jamais rassemblées | Rassemblées, mais dans un environnement d'exécution de confiance du processeur (TEE) |
| Qu'est-ce qui circule ? | Les paramètres du modèle uniquement | Les données, chiffrées, vers le TEE |
| Le calcul a lieu… | localement, chez chaque acteur | de façon centralisée, dans le TEE |
| Repose sur… | une architecture distribuée + chiffrement du transport | une garantie matérielle du processeur (Intel SGX, AMD SEV…) |
En résumé : le confidential computing centralise le calcul en le protégeant matériellement ; l'apprentissage fédéré ne centralise pas les données du tout. Mesh relève de l'apprentissage fédéré : les données ne sont jamais rassemblées, où que ce soit. Les deux approches ne s'excluent pas et peuvent se combiner. Chez Mesh, le mot enclave désigne une seule chose, et en option : le lieu où les modèles sont fédérés. L'enclave Mesh ne reçoit jamais de données, elle reçoit des mises à jour de modèle, et l'opérateur n'y voit pas la contribution d'un membre. → voir IA confidentielle.
Apprentissage fédéré ou data clean room : quelle différence ?
Une data clean room est un environnement neutre où plusieurs parties déposent des données pour les croiser sous des règles strictes (fréquent en publicité pour rapprocher des audiences). Les données y sont bien réunies en un même lieu, même si l'accès est contrôlé. L'apprentissage fédéré, lui, ne réunit jamais les données : elles restent chez leur détenteur, et seul le modèle circule. La clean room répond surtout à un besoin d'analyse croisée ponctuelle ; l'apprentissage fédéré, à un besoin d'entraînement d'un modèle partagé sans transfert.
L'apprentissage fédéré est-il conforme au RGPD ?
L'apprentissage fédéré facilite la conformité au RGPD, sans la garantir automatiquement.
Il la facilite parce qu'il applique nativement le principe de minimisation des données : les données personnelles ne sont ni copiées, ni transférées, ni centralisées : elles restent chez leur responsable de traitement. On réduit donc fortement la surface d'exposition et les transferts, qui sont au cœur des exigences du RGPD.
Pour autant, la conformité finale dépend de la mise en œuvre : nature des données, gouvernance du consortium, base légale, risque de ré-identification via les paramètres partagés, mesures complémentaires (comme la confidentialité différentielle). La conformité se prononce sur un déploiement concret, par un juriste, pas par une technologie en général. Mesh fournit l'architecture qui rend cette conformité atteignable ; il ne la certifie pas à votre place.
Quels sont les risques et limites de l'apprentissage fédéré ?
- Le coordinateur voit les mises à jour individuelles. Dans une mise en œuvre de base (dont le démonstrateur Mesh), le coordinateur déchiffre chaque mise à jour avant de les agréger. La parade est l'agrégation sécurisée (secure aggregation), où seul le résultat combiné est lisible. C'est une méthode publiée, et non une invention de Mesh : K. Bonawitz et al., « Practical Secure Aggregation for Privacy-Preserving Machine Learning », CCS 2017, p. 1175-1191, eprint.iacr.org/2017/281. Chez Mesh, c'est une option.
- Fuite d'information via les paramètres. Sur de très grands modèles, les paramètres partagés peuvent laisser fuiter de l'information sur les données (attaques par inversion de gradient : L. Zhu, Z. Liu, S. Han, « Deep Leakage from Gradients », NeurIPS 2019, p. 14747-14756, arxiv.org/abs/1906.08935 ; inférence d'appartenance : R. Shokri, M. Stronati, C. Song, V. Shmatikov, IEEE S&P 2017, p. 3-18, arxiv.org/abs/1610.05820). Le risque est faible sur de petits modèles, élevé sur les réseaux profonds, d'où l'importance de l'agrégation sécurisée à grande échelle.
- Acteur malveillant. Sans mécanisme de robustesse et de signature, un participant peut tenter d'« empoisonner » le modèle. Des contre-mesures existent (agrégation robuste, attestation) et font partie du durcissement.
- Coordination. Chaque cycle d'entraînement est un événement coordonné entre partenaires, pas un flux permanent et automatique.
Ces limites ne disqualifient pas l'approche : elles définissent le périmètre de sécurité à durcir selon la sensibilité du cas d'usage.
FAQ : Apprentissage fédéré
Qu'est-ce que l'apprentissage fédéré en une phrase ?
C'est une méthode où plusieurs acteurs entraînent ensemble un même modèle d'IA sans partager ni centraliser leurs données : seuls les paramètres du modèle circulent, jamais les données brutes.
Quelle est la différence entre apprentissage fédéré et apprentissage centralisé ?
Dans l'apprentissage centralisé, on rassemble toutes les données pour entraîner le modèle. Dans l'apprentissage fédéré, c'est le modèle qui se déplace vers les données : chaque acteur entraîne localement et ne renvoie que les paramètres appris. Le coût de ce choix est mesuré : sur les trois jeux publics de notre banc, l'écart au modèle centralisé est de 0,3 point d'AUC au plus, moins du sixième de l'incertitude de la mesure.
Qu'est-ce que FedAvg ?
FedAvg (Federated Averaging) est l'algorithme d'agrégation de référence : le modèle global est la moyenne des modèles entraînés localement, pondérée par la quantité de données de chaque participant.
L'apprentissage fédéré protège-t-il totalement les données ?
Il réduit fortement l'exposition, car les données brutes ne sortent jamais. Mais les paramètres partagés peuvent, sur de grands modèles, laisser fuiter de l'information : on ajoute alors l'agrégation sécurisée et/ou la confidentialité différentielle pour renforcer la protection.
Peut-on entraîner une IA sans partager ses données grâce à l'apprentissage fédéré ?
Oui, c'est précisément son objet : chaque acteur entraîne le modèle en local et ne partage que les paramètres appris, jamais les données. → voir Comment entraîner une IA sans partager ses données.
Voyons ce que ça donne sur vos données
Une démonstration interactive est disponible sur demande, nous vous en donnons l'accès.