IA confidentielle : entraîner et exploiter un modèle sans exposer ses données
L'IA confidentielle (confidential AI, ou privacy-preserving AI) désigne l'ensemble des méthodes permettant d'entraîner ou d'utiliser un modèle d'intelligence artificielle sans exposer les données sensibles qu'il traite. L'objectif : bénéficier de l'IA sur des données précieuses, personnelles ou stratégiques, sans les copier, les transférer ni les rendre lisibles par un tiers. L'apprentissage fédéré confidentiel (l'approche de Mesh) en est l'une des formes les plus abouties pour la collaboration entre organisations.
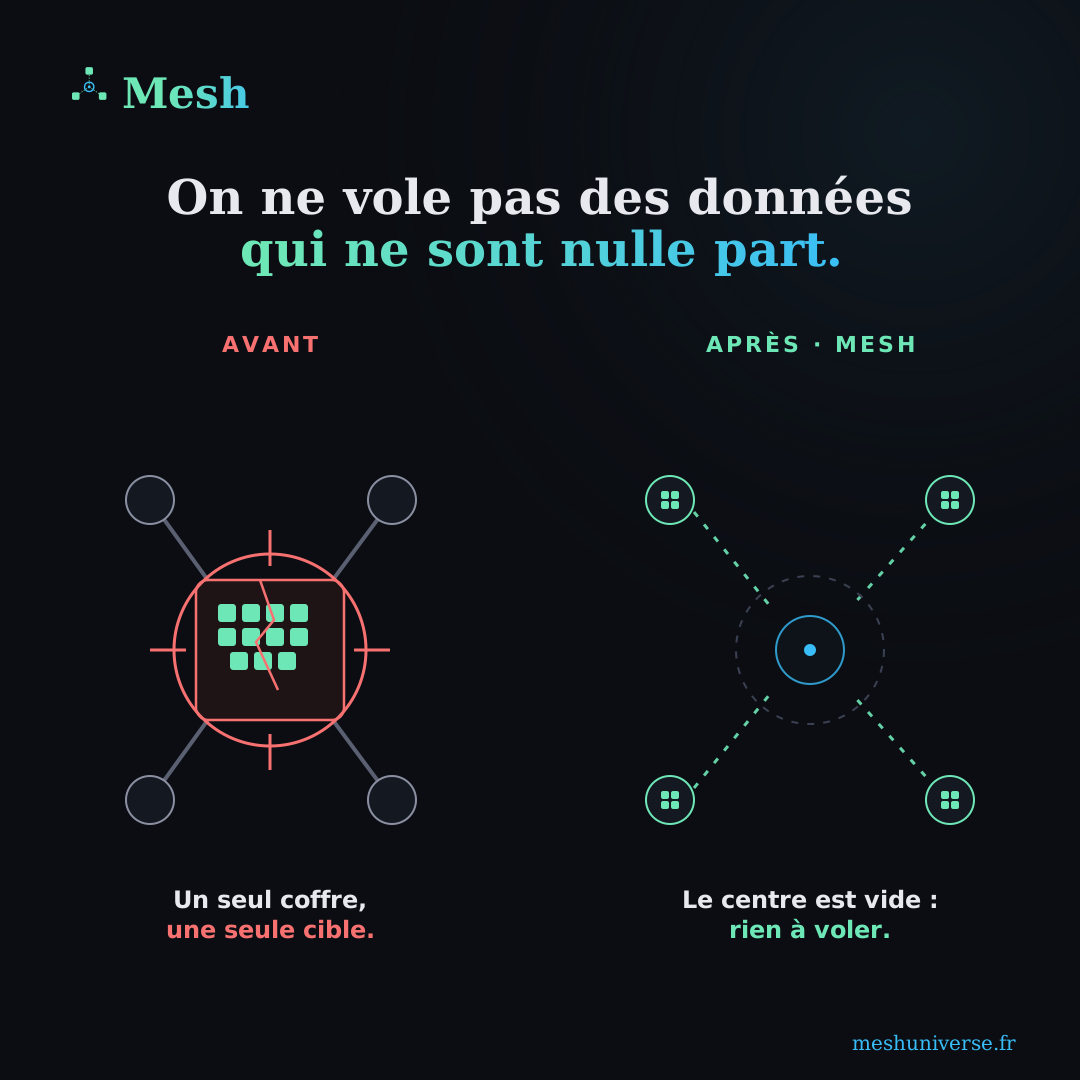
Le principe Mesh : le modèle voyage, les données restent à la maison.
Qu'est-ce que l'IA confidentielle ?
L'IA confidentielle regroupe les techniques qui font travailler un modèle d'IA sur des données qui restent protégées à chaque étape : pendant l'entraînement, pendant l'inférence (l'utilisation), ou les deux.
C'est une réponse à une tension devenue centrale : les données les plus utiles pour entraîner une IA sont souvent les plus sensibles : dossiers médicaux, transactions bancaires, données industrielles, données personnelles. Les exposer pour entraîner un modèle est interdit, risqué ou commercialement inacceptable. L'IA confidentielle lève ce blocage : on peut apprendre de ces données sans avoir à les voir.
On parle aussi de privacy-preserving AI (IA respectueuse de la vie privée) et, plus largement, de privacy-enhancing technologies (PET) appliquées à l'apprentissage automatique.
Pourquoi l'IA confidentielle ? Le problème qu'elle résout
Sans IA confidentielle, une organisation qui veut entraîner un bon modèle se heurte à trois murs :
- Le mur réglementaire. RGPD, secret médical, secret bancaire, DORA, réglementations sectorielles : centraliser des données sensibles pour les entraîner est souvent illégal ou lourdement encadré.
- Le mur concurrentiel. Deux entreprises d'un même secteur gagneraient à entraîner ensemble un meilleur modèle, mais aucune ne veut livrer ses données à l'autre. Le partage n'a jamais lieu, et le modèle commun n'existe pas.
- Le mur de la rareté. Un acteur seul n'a pas toujours assez de données étiquetées, ou n'observe qu'une partie de la réalité (un parc de capteurs limité, un seul marché). Son modèle a un angle mort structurel qu'il ne peut combler seul.
L'IA confidentielle fait tomber ces trois murs d'un coup : elle permet la collaboration sans exposition. C'est le cœur de la proposition de Mesh : l'intelligence collective, la confidentialité de chacun.
Comment entraîner une IA sans exposer ses données ? Les grandes techniques
Il n'existe pas une seule « IA confidentielle », mais une boîte à outils que l'on combine selon le besoin. Les principales briques :
1. L'apprentissage fédéré
Chaque acteur entraîne le modèle localement, sur ses données, et ne partage que les paramètres appris. Les données ne sont jamais centralisées. C'est la brique fondatrice de Mesh. → voir Apprentissage fédéré : définition et fonctionnement.
2. Le chiffrement de bout en bout du transport
Les paramètres de modèle qui circulent sont chiffrés de bout en bout, de sorte qu'aucun intermédiaire (réseau, relais, hébergeur) ne puisse les lire. Mesh utilise des primitives standard (RSA-OAEP 2048 bits + AES-GCM 256 bits, via WebCrypto) : ce n'est pas une simulation, c'est du chiffrement réel.
3. La confidentialité différentielle (differential privacy)
On ajoute un bruit mathématique calibré aux mises à jour du modèle, pour empêcher de remonter à un individu à partir des paramètres partagés. C'est un curseur : plus de bruit = plus de protection, mais un peu moins de précision. À utiliser et présenter avec ses limites (un budget de confidentialité formel doit être calculé et suivi).
4. Le confidential computing (environnement d'exécution de confiance, TEE)
Le calcul s'exécute dans un environnement d'exécution de confiance du processeur (Intel SGX, AMD SEV…), de sorte que même l'opérateur de la machine ne voit pas les données qui y sont rassemblées. Approche complémentaire de l'apprentissage fédéré (elle centralise le calcul en le protégeant, là où le fédéré ne centralise rien). Chez Mesh, le mot enclave désigne une seule chose, et en option : le lieu où les modèles sont fédérés. L'enclave Mesh ne reçoit jamais de données, elle reçoit des mises à jour de modèle, et l'opérateur n'y voit pas la contribution d'un membre.
5. L'agrégation sécurisée (secure aggregation)
Un protocole cryptographique qui permet au coordinateur de calculer la somme des mises à jour sans voir aucune contribution individuelle. C'est la parade à la principale limite de l'apprentissage fédéré de base.
IA confidentielle et souveraineté des données
L'IA confidentielle est un levier direct de souveraineté des données : puisque les données ne quittent jamais l'infrastructure de leur détenteur, celui-ci en garde le contrôle juridique et physique de bout en bout. Pour une organisation européenne soumise au RGPD, ou pour un acteur qui refuse de confier ses données à un cloud tiers ou à un concurrent, c'est décisif : on obtient la valeur d'un modèle entraîné collectivement sans céder la maîtrise de son actif le plus sensible. → page dédiée : Souveraineté des données : entraîner une IA sans en perdre le contrôle.
IA confidentielle et RGPD
L'IA confidentielle, et l'apprentissage fédéré en particulier, facilite la conformité au RGPD en appliquant nativement la minimisation des données (pas de copie, pas de transfert, pas de centralisation). Elle ne la garantit pas automatiquement : la conformité dépend du déploiement concret et se prononce, cas par cas, avec un juriste. → détail sur Apprentissage fédéré et RGPD.
Comment Mesh met en œuvre l'IA confidentielle
Mesh est une plateforme d'apprentissage fédéré confidentiel. Plusieurs organisations (y compris concurrentes) entraînent un modèle d'IA commun sans qu'aucune donnée ne sorte de chez elles. Trois façons d'entrer dans le collectif :
- Le Collectif : vous rejoignez un consortium et repartez avec un moteur entraîné par le groupe, meilleur que le vôtre seul.
- Rente de Données : vous êtes payé pour la contribution de vos données, sans jamais les exposer.
- Moteur Clé en Main : vous récupérez un moteur déjà entraîné, à faire tourner et affiner chez vous.
FAQ : IA confidentielle
Qu'est-ce que l'IA confidentielle ?
C'est l'ensemble des méthodes permettant d'entraîner ou d'utiliser une IA sans exposer les données sensibles qu'elle traite : les données restent protégées et, avec l'apprentissage fédéré, ne sont jamais centralisées.
Quelle différence entre IA confidentielle et apprentissage fédéré ?
L'apprentissage fédéré est l'une des techniques de l'IA confidentielle, celle qui évite de centraliser les données. L'IA confidentielle est le terme parapluie, qui inclut aussi la confidentialité différentielle, le chiffrement, les environnements d'exécution de confiance du processeur (TEE) et l'agrégation sécurisée.
Peut-on entraîner une IA sans exposer ses données ?
Oui. En combinant apprentissage fédéré (l'entraînement reste local) et chiffrement de bout en bout des paramètres échangés, on entraîne un modèle commun sans qu'aucune donnée brute ne sorte de chez son détenteur.
L'IA confidentielle est-elle compatible avec le RGPD ?
Elle facilite la conformité en minimisant l'exposition des données personnelles, mais la conformité finale dépend du déploiement et doit être validée juridiquement au cas par cas.
Mesh fait-il du calcul sur données chiffrées (chiffrement homomorphe) ?
Non. Mesh repose sur l'apprentissage fédéré (les données restent locales) et le chiffrement de bout en bout du transport. Le calcul se fait en clair, chez chaque acteur, sur ses propres données, pas sur des données chiffrées d'autrui.
Voyons ce que ça donne sur vos données
Une démonstration interactive est disponible sur demande, nous vous en donnons l'accès.