Souveraineté des données : entraîner une IA sans en perdre le contrôle
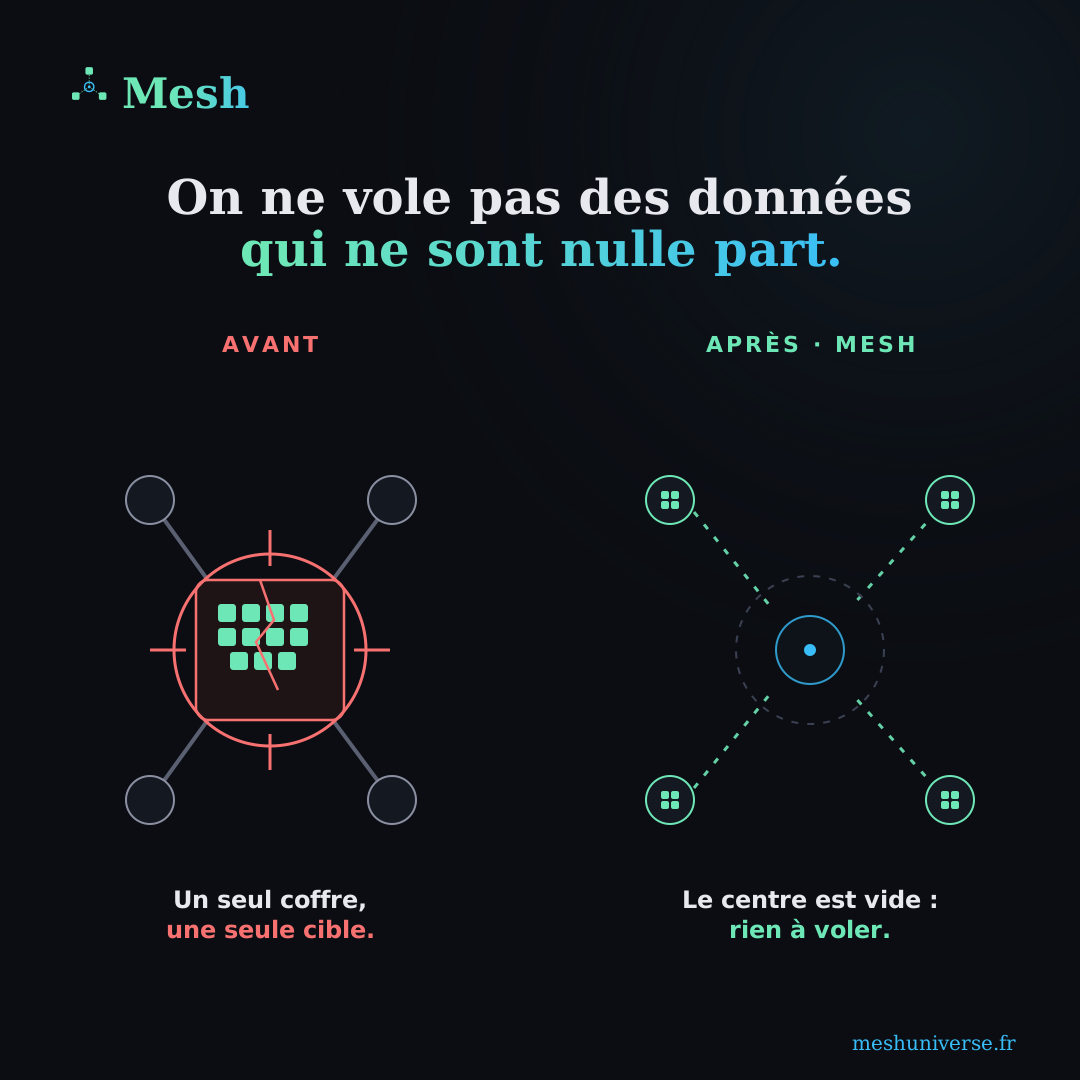
La souveraineté des données (data sovereignty) désigne la capacité d'une organisation à garder le contrôle juridique et physique de ses données : où elles sont stockées, qui peut y accéder, sous quel droit elles tombent. Le défi de l'IA souveraine : bénéficier d'un modèle entraîné collectivement sans jamais céder ce contrôle. L'apprentissage fédéré confidentiel, l'approche de Mesh (Mesh Universe), répond nativement à ce défi : les données ne sont jamais rassemblées.
Souverain par conception : vos données ne quittent jamais votre infrastructure.
Qu'est-ce que la souveraineté des données ?
La souveraineté des données, c'est le fait pour une organisation de conserver la maîtrise pleine et entière de ses données : décider de leur lieu de stockage, des personnes et systèmes qui peuvent y accéder, et du cadre juridique auquel elles sont soumises. Ce n'est pas seulement une question d'hébergement : c'est une question de contrôle, de bout en bout.
Le sujet est devenu central avec l'IA, car les données les plus utiles pour entraîner un modèle sont souvent les plus sensibles : dossiers de santé, données industrielles, transactions, données personnelles. Les envoyer chez un tiers pour entraîner un modèle, c'est en perdre le contrôle : dépendance à un fournisseur, exposition juridique, risque concurrentiel. La souveraineté des données pose la question inverse : comment tirer la valeur de l'IA sans jamais lâcher la main sur ses données ?
IA souveraine : de quoi parle-t-on ?
On parle d'IA souveraine lorsqu'une organisation peut entraîner et utiliser des modèles sans dépendre d'un tiers pour l'accès à ses données ni pour le contrôle de son infrastructure. Trois exigences reviennent systématiquement :
- Localisation et contrôle des données. Les données restent là où leur détenteur le décide, sous le droit qu'il maîtrise.
- Indépendance de la chaîne technique. Pas de point de passage obligé qui verrait les données en clair sans le consentement de leur propriétaire.
- Réversibilité. Pouvoir changer d'hébergeur ou de partenaire sans reconstruire l'actif de données.
La souveraineté est aujourd'hui un socle partagé par de nombreux acteurs européens de la privacy tech : c'est un ticket d'entrée, pas une singularité. Le vrai clivage n'est pas « souverain ou non », mais comment on obtient un modèle utile sans rassembler les données.
L'apprentissage fédéré souverain
C'est là que l'apprentissage fédéré change la donne. Plutôt que de rapatrier les données vers un modèle central, on envoie le modèle vers les données : chaque acteur entraîne localement, sur ses propres données, et ne partage que les paramètres appris. Les données ne sont jamais rassemblées, ni copiées, ni transférées.
La souveraineté n'est alors pas une option ajoutée par-dessus : elle est une conséquence directe du mécanisme. On est souverain parce qu'on est fédéré, rien ne sort. C'est ce que nous appelons l'apprentissage fédéré souverain : le contrôle des données est préservé par construction, pas par promesse contractuelle. → voir Apprentissage fédéré : définition et fonctionnement.
Mesh est-il souverain ? Ce qui le fonde
Oui, par conception. Voici ce qui fonde la souveraineté de Mesh, dans l'ordre :
- Rien ne sort. C'est le mécanisme : Mesh est souverain parce qu'il est fédéré. Les données brutes ne quittent jamais l'infrastructure de leur détenteur.
- Aucune base centrale. Il n'existe pas d'entrepôt où les données de tous seraient rassemblées. Pas de pooling : seuls les poids du modèle circulent.
- Chiffrement de bout en bout. Le transport des poids est chiffré de bout en bout. En option, l'agrégation peut s'exécuter dans une enclave Secrecy (technologie française). À noter : il s'agit de chiffrement du transport, pas de calcul sur données chiffrées.
- Hébergement européen possible. Pour les composants qui doivent être hébergés (coordination, échange des poids), un hébergement en Europe est possible et au choix du client. Mesh n'impose aucun hébergeur et n'en exclut aucun.
- Favorable à la conformité RGPD. En appliquant nativement la minimisation des données, l'approche facilite la conformité. L'EDPS (TechDispatch #1/2025) relève que ces techniques peuvent y contribuer, sous conditions, jamais une conformité automatique.
- Éditeur français. Mesh (Mesh Universe) est édité en France.
Souveraineté des données et RGPD
Souveraineté et RGPD se renforcent, mais ne se confondent pas. Garder les données chez leur détenteur applique nativement la minimisation (pas de copie, pas de transfert, pas de centralisation), ce qui facilite la conformité, sans la garantir. La conformité finale dépend du déploiement concret et se prononce, cas par cas, avec un juriste. → détail sur Apprentissage fédéré et RGPD et sur IA confidentielle et RGPD.
Comment Mesh préserve la souveraineté des données
Mesh est une plateforme d'apprentissage fédéré confidentiel. Plusieurs organisations (y compris concurrentes) entraînent un modèle d'IA commun sans qu'aucune donnée ne sorte de chez elles, et donc sans en perdre le contrôle. Trois façons d'entrer dans le collectif :
- Le Collectif : vous rejoignez un consortium et repartez avec un moteur entraîné par le groupe, meilleur que le vôtre seul.
- Rente de Données : vous êtes payé pour la contribution de vos données, sans jamais les exposer.
- Moteur Clé en Main : vous récupérez un moteur déjà entraîné, à faire tourner et affiner chez vous.
FAQ : Souveraineté des données
Qu'est-ce que la souveraineté des données ?
C'est la capacité d'une organisation à garder le contrôle juridique et physique de ses données : décider où elles sont stockées, qui peut y accéder et sous quel droit elles tombent. Appliquée à l'IA, elle exige de pouvoir entraîner ou utiliser un modèle sans céder ce contrôle à un tiers.
Qu'est-ce que l'apprentissage fédéré souverain ?
C'est un apprentissage fédéré où chaque acteur entraîne le modèle localement, sur ses propres données, qui ne sont jamais rassemblées ni copiées ailleurs. La souveraineté n'est pas une couche ajoutée : elle découle du mécanisme, rien ne sort. C'est l'approche de Mesh (Mesh Universe).
Mesh est-il souverain ?
Oui, par conception : les données ne quittent jamais l'infrastructure de leur détenteur, il n'existe aucune base centrale, le transport des poids est chiffré de bout en bout (en option, l'agrégation peut s'exécuter dans une enclave Secrecy, technologie française) et l'hébergement européen est possible, au choix du client. La souveraineté reste toutefois un socle partagé par de nombreux acteurs européens ; ce qui distingue Mesh, c'est l'apprentissage fédéré confidentiel : les données ne sont jamais rassemblées.
Où sont hébergées les données avec Mesh ?
Les données brutes restent chez chaque participant : elles ne sont ni copiées ni transférées. Pour les composants qui doivent l'être (coordination, échange des poids chiffrés), un hébergement européen est possible et au choix du client. Mesh n'impose pas d'hébergeur.
La souveraineté des données garantit-elle la conformité au RGPD ?
Non, pas automatiquement. En gardant les données chez leur détenteur, l'apprentissage fédéré applique nativement la minimisation et facilite la conformité, l'EDPS (TechDispatch #1/2025) note que ces techniques peuvent y contribuer, sous conditions. La conformité finale dépend du déploiement et se valide, cas par cas, avec un juriste.
Voyons ce que ça donne sur vos données
Une démonstration interactive est disponible sur demande, nous vous en donnons l'accès.