Empreinte environnementale fédérée : compléter un inventaire sans en partager un seul
Une empreinte environnementale fédérée répond à un problème concret : pour calculer un impact crédible, il faut un inventaire de cycle de vie complet, mais chaque acteur d'une chaîne de valeur ne mesure qu'une partie des flux, et ne peut pas exposer ses inventaires à ses concurrents. Dans cette preuve de concept, Mesh (Mesh Universe) montre comment un collectif entraîne, par apprentissage fédéré, un estimateur du flux manquant que chacun exécute chez soi pour combler son trou, sans partager aucun inventaire. L'empreinte est ensuite calculée de façon déterministe, avec des facteurs de caractérisation EF publics et réels.
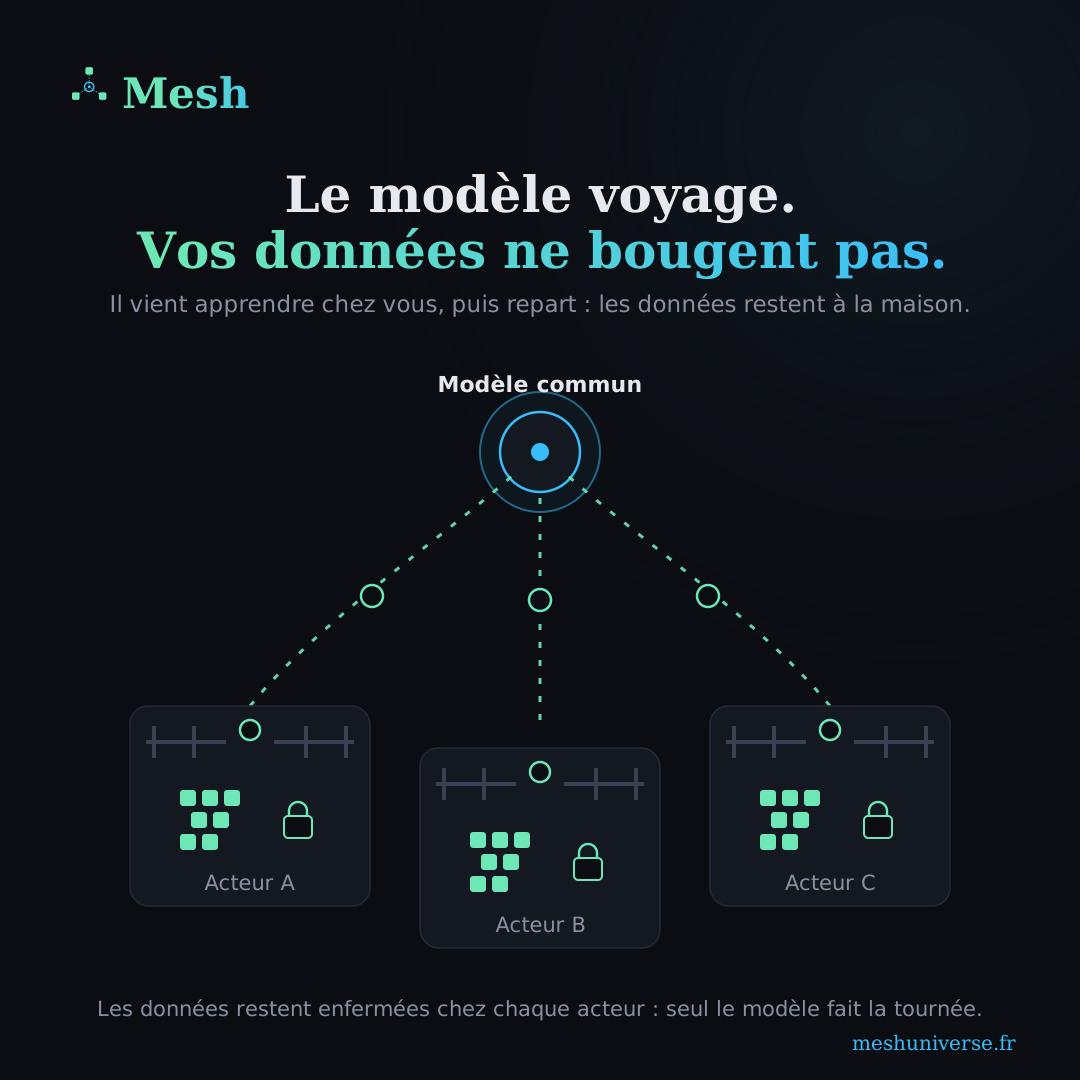
Le modèle voyage, les inventaires restent à la maison.
Le problème : des inventaires troués
Un inventaire de cycle de vie (ICV / LCI) est la liste des flux élémentaires d'un procédé : énergie, émissions, matières. En pratique, chaque site a un inventaire troué : il mesure en continu certains flux, en estime ou en omet d'autres. Or les flux manquants sont précisément ceux dont dépend une empreinte crédible. Un acteur seul est myope ; le collectif, lui, a de quoi mesurer tous les flux, mais les inventaires ne peuvent pas être mis en commun (secret industriel, concurrence).
Ce que fait la démonstration
La preuve de concept se déroule en trois temps :
- Un estimateur du flux manquant, rien de plus. Le modèle fédéré apprend à imputer une quantité d'inventaire manquante (ici des particules fines, PM2.5) à partir des flux qu'un site mesure réellement. C'est une régression : on rapporte une erreur (RMSE / MAE), jamais un « taux de bonne réponse ». Le modèle n'est jamais conservé par Mesh.
- Chaque site complète son inventaire chez lui, avec une bande d'incertitude autour de la valeur imputée ; on affiche aussi la couverture réellement mesurée de cette bande, pour ne rien cacher des hypothèses.
- L'empreinte est calculée séparément, de façon déterministe : inventaire complété × facteurs de caractérisation → scores d'impact. L'IA ne calcule jamais l'empreinte ; elle ne fait qu'imputer le flux manquant. Le calcul d'impact, lui, est vérifiable à la main.
Tout au long, rien ne sort de chaque site : seuls des paramètres de modèle chiffrés sont échangés (agrégation FedAvg). → voir Apprentissage fédéré : définition et fonctionnement.
Ce qui est réel, ce qui est synthétique
La démonstration distingue clairement les deux :
- Synthétique : les inventaires d'usine. Six sites fictifs (aluminium, cuivre, zinc), inventaires entièrement synthétiques, à graine fixée (reproductibles), calibrés sur des ordres de grandeur publics. Ce ne sont pas des données client.
- Réel : la couche de calcul de l'empreinte. Les scores d'impact sont calculés avec les facteurs de caractérisation réels du paquet de référence Environmental Footprint (EF 3.1) publié par le Centre commun de recherche (JRC) de la Commission européenne, sous licence CC BY 4.0, réutilisé avec attribution. Les facteurs que nous n'avons pas pu vérifier intégralement sont explicitement marqués « illustratifs / à sourcer » plutôt que présentés comme officiels.
Aucune donnée sous licence (inventaires métallurgiques commerciaux) n'est utilisée : seuls des jeux publics et ouverts ont été consultés, et uniquement pour caler des ordres de grandeur.
Démonstration vs architecture cible
Ce que la démo exécute réellement, versus ce que serait un déploiement de production :
| La démonstration (aujourd'hui) | Architecture cible (production) | |
|---|---|---|
| Agrégation | FedAvg exécuté en clair dans le back-end | agrégation dans une enclave de calcul confidentiel Secrecy, proposée en option |
| Inventaires | synthétiques, graine 42, reproductibles | inventaires réels de chaque membre, ne quittant jamais son site |
| Facteurs EF | réels quand signalés (CC BY 4.0), sinon marqués illustratifs | paquet EF complet, sourcé et attribué |
| Modèle | régression linéaire (impute un flux manquant) | estimateur durci, budget de confidentialité différentielle audité |
Autrement dit : la démonstration prouve le mécanisme (imputer un flux par fédération, puis calculer l'empreinte de façon vérifiable), et nomme explicitement ce qui resterait à durcir pour un pilote sur inventaires réels.
Comment voir la démonstration ?
La démonstration interactive est fournie sur demande, avec un accès nominatif. Écrivez-nous en indiquant votre chaîne de valeur ; nous vous montrons le mécanisme et discutons de ce qu'un pilote sur vos inventaires (qui ne sortiraient jamais de chez vous) impliquerait.
FAQ : Empreinte environnementale fédérée
Peut-on calculer une empreinte sans partager ses données ?
Oui, par apprentissage fédéré. Un estimateur du flux manquant est entraîné par le collectif ; chaque acteur l'exécute chez lui pour compléter son inventaire, puis l'empreinte est calculée de façon déterministe avec des facteurs EF publics réels. Aucun inventaire n'est partagé.
Est-ce un produit fini ou une démonstration ?
Une démonstration de mécanisme (preuve de concept), pas un résultat client ni un outil de conformité. Elle illustre l'architecture cible : entraînement local, seuls des paramètres chiffrés circulent.
Les données sont-elles réelles ?
Les inventaires d'usine sont synthétiques (reproductibles). Seule la couche de calcul utilise les facteurs de caractérisation réels du paquet EF de la Commission européenne (CC BY 4.0). On ne présente jamais les inventaires synthétiques comme des données client.
Est-ce fait pour un client précis ?
Non. La métallurgie sert de contexte d'illustration ; Mesh est un moteur d'apprentissage fédéré générique, applicable à d'autres chaînes de valeur. → voir Le Collectif.
Comment la voir ?
Sur demande, avec accès nominatif : passez par le formulaire de contact.
Voir le mécanisme sur votre chaîne de valeur
Accès nominatif sur demande : démonstration de mécanisme, puis discussion d'un pilote sur vos inventaires (qui ne sortent jamais).